« Qui risque de partir ? » et « Qui cette offre peut-elle faire changer d'avis ? » ne sont pas la même question.
Cela n'exige aucune hallucination. Seulement quelque chose de plus discret : traiter une prédiction comme la preuve qu'une action précise va aider.
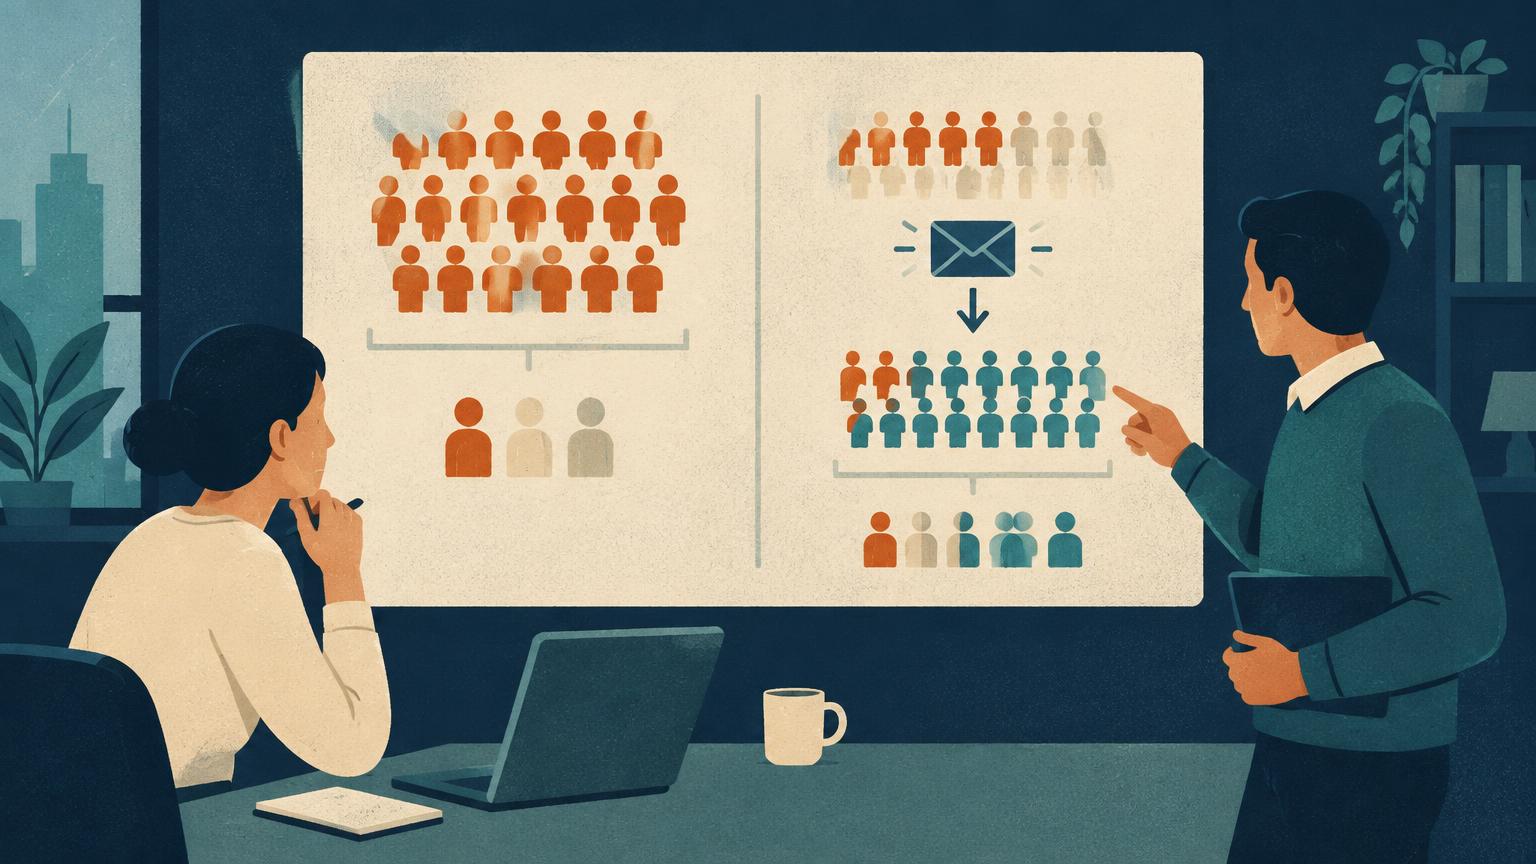
Deux groupes, une offre
Imaginons deux groupes de 100 clients. Les chiffres sont fictifs. On suppose l'effet attendu de la même offre estimé de façon fiable, et des coûts de campagne et une valeur par client retenu identiques.
Un classement au risque met A en premier. Mais l'offre évite cinq départs attendus dans A et vingt-cinq dans B. Sous ces hypothèses, B est la meilleure cible pour cette offre. Et rien n'exige que le classement au risque soit faux : A reste le groupe le plus à risque.
L'expression clé est « grâce à l'offre ». On ne compte pas tous ceux qui sont restés après l'avoir reçue, mais la différence entre ce qui arriverait avec et sans elle. Ce sont deux scénarios alternatifs par groupe, pas une comparaison avant/après sur deux mois.
Risque et effet sont deux quantités
Un score de churn estime la probabilité de départ dans les conditions représentées par le modèle et ses données, qui peuvent mêler d'anciennes politiques commerciales. Sauf design contraire, ce n'est pas un « risque sans intervention ». Un effet d'intervention mesure comment un résultat change sous une action donnée par rapport à une alternative donnée ; EconML le formalise via l'estimation d'effets de traitement hétérogènes [1].
Le scénario manquant ne se lit pas dans une ligne
Pour un client, on observe ce qui s'est passé sous l'action reçue, jamais sous l'alternative. Comparer clients contactés et non contactés ne règle rien : les commerciaux ciblent parfois ceux qui montrent déjà des signaux, ou ceux qu'ils croient faciles à retenir. Une expérience randomisée bien conçue crée une comparaison défendable ; l'estimation observationnelle repose sur des hypothèses explicites. Un modèle causal ne fait pas disparaître les hypothèses d'identification manquantes [2].
Ce qu'un agent doit vérifier avant de proposer la campagne
- 01OBJECTIFRenouvellements additionnels, marge, valeur long terme ?
- 02PREUVE D'INTERVENTIOND'où vient l'effet estimé ? Quelle offre testée ? Population comparable ?
- 03ÉCONOMIE ET CONTRAINTESVolume d'offres, coût pour ceux qui seraient restés, limites opérationnelles.
- 04INCERTITUDEAssez solide pour choisir une politique, ou seulement pour une meilleure expérience ?
Ce sont des exigences proposées pour l'aide à la décision, pas l'affirmation qu'un logiciel a déjà résolu l'inférence causale.
Un bon test inclut savoir quand ne pas répondre
CausalDS, préprint soumis le 9 juillet 2026, propose un benchmark de raisonnement causal pour agents data science, sur structures et données synthétiques. Reconnaître qu'une question ne justifie pas de réponse y est explicitement évalué [3]. Cela ne prouve aucune efficacité réelle sur une campagne, mais porte un principe utile : distinguer une réponse justifiée d'une réponse simplement produisible. Sans preuve d'intervention, un agent ne doit pas fabriquer la ligne « avec offre ».
D'une estimation d'effet à une décision
Le coût doit inclure les conséquences économiques de l'offre, pas seulement l'envoi de l'e-mail : une remise réduit la marge sur ceux qui auraient renouvelé de toute façon. La capacité et le timing comptent aussi. L'avantage de la formule : forcer l'équipe à dire ce qu'elle optimise.
Garder la frontière entre trois réponses
- Observation : tant de clients ont renouvelé, selon une définition donnée.
- Prédiction : ces clients ont une probabilité estimée de non-renouvellement.
- Aide à la décision : cette action peut améliorer le résultat, selon ces preuves et ces hypothèses.
La prochaine fois qu'une IA recommande une action, posez une question de plus : qu'est-ce qui prouve que cette action changera le résultat ?
L'exemple chiffré est fictif. Ce n'est ni un résultat client, ni l'annonce de capacités de modélisation causale dans DUKE.
Sources
- [1] PyWhy / EconML, motivation : heterogeneous treatment effects.
- [2] PyWhy / DoWhy, causal inference with DoWhy and EconML.
- [3] Leban et Sun, CausalDS: Benchmarking Causal Reasoning in Data-Science Agents, arXiv:2607.08093, soumis le 9 juillet 2026. Préprint, benchmark synthétique.